 超算云
 AI智算云
北京超算吴迪:MaaS的终局不是“接模型”,是敢签交付合同
本文转载自:亿欧网
记者:刘政鑫
大模型行业最擅长造神。
参数、榜单、发布会,一轮接一轮。
但真正让采购负责人睡不着觉的,从来不是“模型又强了”。而是一组不太“亮眼”的问题:一笔请求进来,调多少算力、吐多少token、花多少钱、半夜崩了谁接电话、下个版本能不能在周三上线。
2026年上半年,国内token调用量同比上涨数倍,MaaS市场半年规模冲到百亿级别,增速近9倍。行业叙事悄悄转了向:从前比谁训得出模型,现在比谁先把模型做成“能结账、能追责、能跑一整年”的服务。
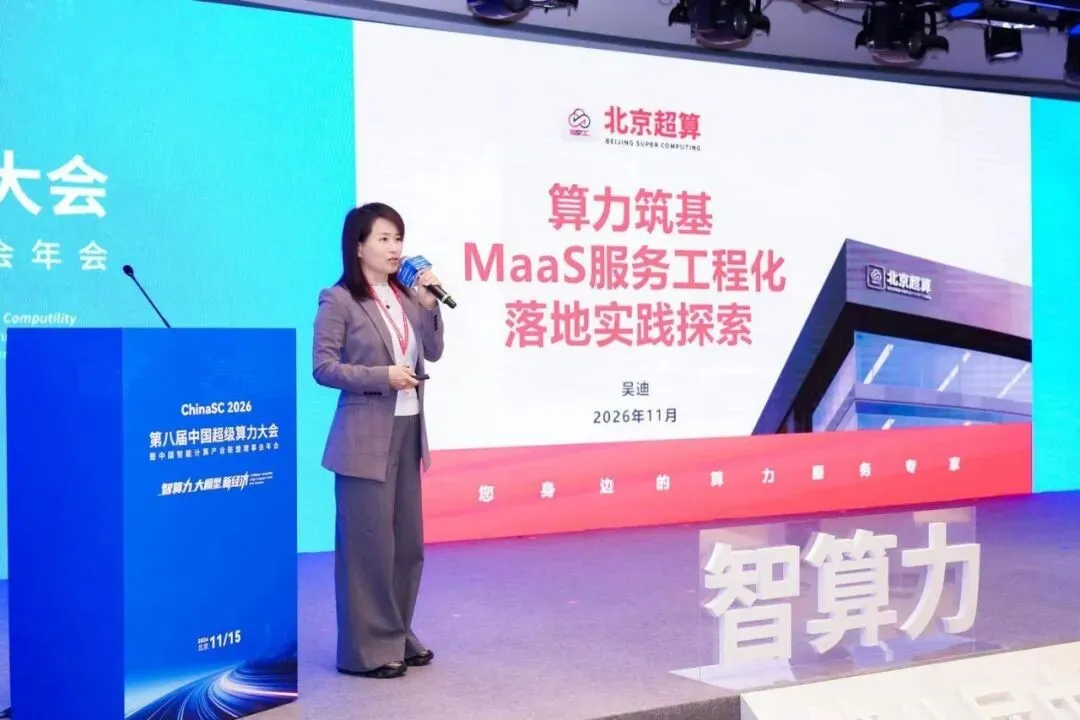
11月15日,第八届中国超级算力大会(ChinaSC2026)现场,北京超算总经理吴迪把这件事讲得很直白。她的身份不止是“算力服务提供商”:中国计算机协会CCF理事、CCF高专委常务委员,清华经管EMBA,深耕超算商业化十余年。
报告标题也很朴素——《算力筑基,MaaS服务工程化落地实践探索》。
“算力筑基”是老本行,“MaaS落地”才是新命题。
北京超算想做的不是再叠一层模型能力,而是把算力、模型、网关、计费、运维焊成一条流水线——客户只管调用,中间怎么转,完全不用管。
从“卖卡”到“卖口粮”,
MaaS把算力重新拆了一遍
过去买算力,像租厂房。先拍板要多少卡,再搭环境、调集群、等任务跑完。闲置是常态,贵也是常态。
今年这个逻辑断了。训练需求没退,推理需求却猛冲上来。AI Coding、智能体、长文本、视频生成,每一个都是token吞噬机。企业不再问“你有多少卡”,而是问“我这一百万次调用,你报个价”。
吴迪的判断很干脆:MaaS的本质,是把算力从“资源”重新整备成“服务”。用户看到的不是一个裸集群,而是一个统一入口——进去选模型,出来拿结果。中间的资源调度、推理引擎、网关、计量计费,全由平台来主动支持。
这一步看着轻,做起来其实是断层、切分。
算力供应商习惯谈“可用核数”“集群规模”;模型厂习惯谈“效果”“上下文长度”。但企业真要的是第三件事:把模型塞进自己的业务流,成本可预期、故障可追责、升级不中断。
北京超算的切法很现实——不做模型,做模型和算力之间的“工程层”。
它把自己定位成中立第三方:不绑某一家模型厂,平台里GLM、DeepSeek、千问多家并存,客户按场景挑。底层是一张可调度200万核以上CPU、近5万张GPU的算力网络。
上层是统一API、统一计量、统一运维。
翻译过来就是:客户不用再自己攒“模型+算力+工程”三件套,直接买成品。
这刚好戳中MaaS当下最痛的一点——模型能力趋同之后,竞争重心从“谁更聪明”滑向“谁更稳、更便宜、更好接”。行业里其实已经有共识:MaaS越来越像“水电煤”生意,模型调用链路一加密,平台很难靠绑数据锁客户,明天出个更强模型,客户随时切走。
所以中立不是姿态,是生存策略。
AI Coding先打样:
不是补全代码,是重做研发流水线
北京超算把重心放在AI Coding上,不是追热点。
Coding是目前少数能明确算ROI的AI场景。一次需求分析、一段生成代码、一轮测试反馈、一次自动提交——每一步都对应人天,都能量化。模型不是陪你聊天,是替你干活。
吴迪在演讲里反复强调一个词:全生命周期。
过去大家理解的AI编程,是IDE里弹一行补全。现在北京超算把它拉到整条研发链:需求拆解、架构设计、代码生成、单测、联调、交付。GLM为主,多模型协同,复杂任务切不同模型跑。
几个客户验证下来的结果:相比纯人工,研发链路整体提效数十个百分比。
这个数字有边界——不是“写代码快”,是“从需求到交付的整体链路提效”。前者是PPT指标,后者才进得了管理层汇报。
更关键的还有工程稳定性。
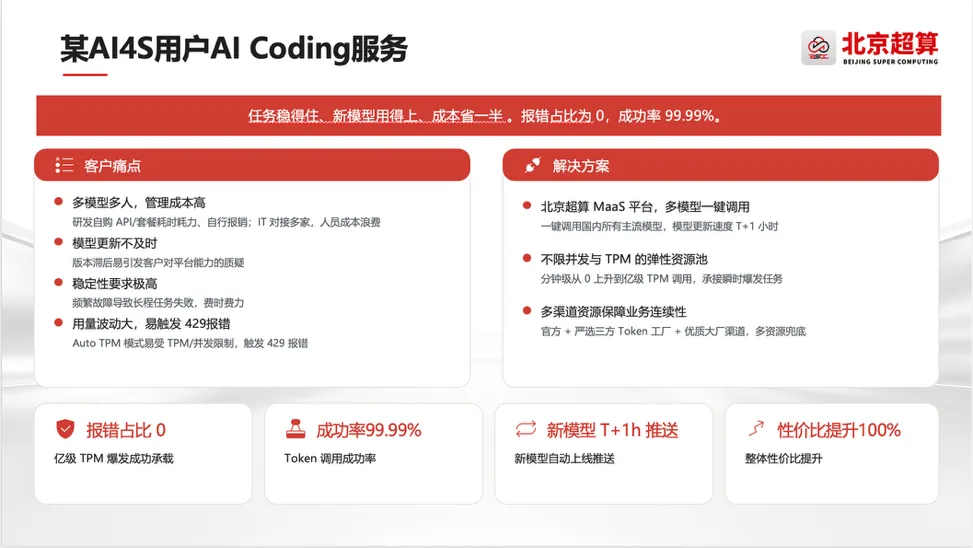
报告里提到一个AI4S领域的典型客户:高并发、批量调用、长期运行,原来每月烧200万,模型更新慢、报错频繁。接北京超算MaaS平台后,以GLM为主、兼容多模型,报错率压到接近零,token调用接入率99.99%,新模型适配做到T+1小时推送,月成本砍到100万。
这组数字的意义不在“便宜一半”,而在证明了一件事:MaaS能进生产环境,而不只停留在PPT演示。
但这里也得泼盆冷水。行业报告里有个词很准——“交付断层”:智能体生成代码的速度,远超团队验证能力。编译通过、测试通过,远不足以判定产物可交付。
也就是说,AI Coding的拐点不在于“写得更快”,而是“验得更准”。
谁能把验证、审计、回滚、成本度量全接上,谁才真正把Coding做成了服务。北京超算的打法恰恰卡在这个位置:模型输出只是起点,后面那截工程链才是壁垒。
教育科研的“隐形战场”:
两万师生逼出的多租户能力
AI落地叙事总围着大厂转,但北京超算最耐看的案例其实在高校。
清华大学校级AI平台,服务两万余名师生。不是某个实验室自己玩,而是全校级底座:科研写作、教学辅助、智能体搭建、AI Coding,全跑在同一套MaaS上。
这类客户有三个特点,正好逼出平台的真实能力:
人多,场景杂。文科生润色论文,工科生跑仿真,计算机系写Agent,同一平台同时接。
预算分多层。个人用公有云API,课题组买团队版,强领域团队要私有化部署。一套平台得拆出多种交付形态。
容错率低。考试季、投稿截止前,平台崩一小时,影响的是真金白银的科研进度。
北京超算的打法,不只是是“租算力给学校”,而是把平台做成科研基础设施。师生直接登录用;课题组走API集中采购;优势学科搭领域专用层。合作高校同期还在推“算力券”机制,MaaS平台涵盖GLM、DeepSeek、Kimi、MiniMax等主流模型,Token计费、按院系配额、资源用量可审计——算力平台从一次性建设项目,转成持续运转的公共设施。
这其实回应了一个被忽视的信号:高校和科研院所的AI化,不是买几个账号就行。它需要多模型、多权限、多部署形态并存,还要审计、隔离、合规。
同样的逻辑复制到企业侧,就是金融、政务、车企这些“数据不能出域”的客户。公有云、混合部署、完全私有化,三档安全等级分开走。混合模式下,敏感数据留本地,推理走云端;高密级单位直接单机房独立部署。
MaaS的“工程化”,说到底就是把这些琐碎约束一个个变成开关,而不是每次重新立项。
这也是为什么北京超算连续七年拿HPC TOP100通用CPU算力第一、服务超1300家企业与科研机构之后,还要反过来做MaaS——它要把“超算中心”重新定义成“模型时代的供水厂”。
护城河不在模型,
在“兜底”
行业有个误区:觉得MaaS门槛低,接个网关调别人模型就行。
但吴迪提到的几个问题很真实——模型版本更新跟不上、高峰期不稳定、出了事没人扛、安全合规留黑洞。这些都不是模型能力问题,是服务工程问题。
北京超算的应对方式很“重”:
百人级服务团队,7×24响应;
大客户配专属人工+兜底机制,常规客户走标准化AI支持;
模型上线前过官方质量认证,GLM、DeepSeek都与原厂标准质量对齐;
传输加密、多租户隔离、访问控制、审计日志全链路留痕;
新模型T+1小时推送到客户环境。
这套东西不低调,但恰恰是MaaS从“能调用”走到“敢调用”的分水岭。
IDC在今年的判断也印证了这一点:MaaS客户关注点正从单点模型能力,转向数据安全、业务定制、自主可控、信创适配,工程化交付与长期运维成为项目成败关键。
换句话说,未来衡量一家MaaS平台,不会再看它接了多少模型,而是看三件事——调用稳不稳,账单清不清,出问题有没有人扛。
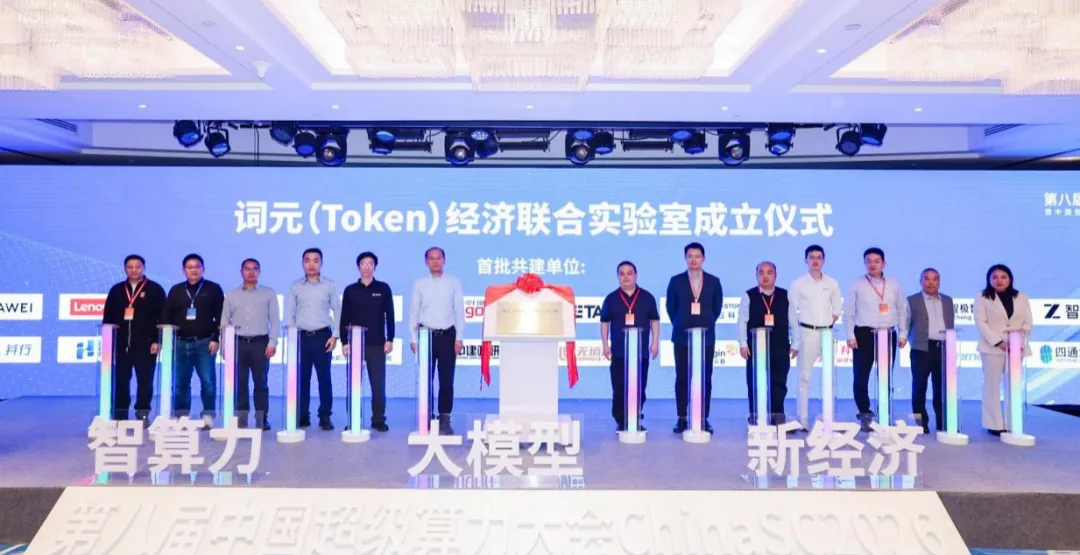
ChinaSC2026同步启动了“词元(Token)经济联合实验室”,把“按token计费”往标准层推。当token变成可计量、可审计、可对比的硬通货,MaaS才真正脱离“卖额度”的初级形态,进入“卖交付”的阶段。
而商业模式也在变。按量付费拿入口,订阅制锁确定性,按效果分润把厂商收入和客户业务成果绑在一起。这意味着MaaS厂商不能再靠“模型新”吃红利,得靠“交付稳”吃复购。
下半场拼的不是模型,
是“交付感”
回头看吴迪这场演讲,标题里“算力筑基”是底色,“MaaS落地”才是正文。
2026年之后,大模型行业会分得更清楚:
上游继续卷模型能力、卷上下文、卷推理效率;
中游拼谁把模型做成稳定服务;
下游拼谁先在真实业务里跑出可量化回报。
北京超算选的位置很巧——不上场训模型,也不下场做应用,而是卡在中间那层最累、最容易被忽略、却又最决定成败的工程带。
AI Coding先打样,教育科研沉淀多租户能力,金融政企验证私有化交付。三条线合起来,指向同一件事:把“模型能力”翻译成“企业能签合同的服务”。
吴迪有一句话可以作为注脚:做好算力选型和场景适配,为用户解决核心问题。
这句听起来平淡,没有大模型时代的那种滚滚洪流的感觉,却是MaaS真正的成人礼。
当行业不再追问“你的模型跑分多少”,而是追问“我下个季度敢不敢把核心业务交给你”——算力时代的“交付感”,才算真正到来。
 相关阅读